リンク切れや画像肥大化をデプロイ前に防ぐ静的サイトの自動品質チェック設計
目次
開閉
静的サイトジェネレーターで作った技術ブログは、記事が10本くらいのうちは公開前に目で見て確認するだけでも何とかなります。ただ、30本、40本と増えて過去記事の修正も重なってくると、気をつけていても細かいミスが少しずつ紛れ込んできます。
例えば、別記事へ張ったリンクのパス打ち間違いや、参照先の外部サイトがいつの間にかURL変更で404になっていたケース、あるいはリサイズし忘れた1MB近い画像をそのままコミットしてしまうことなどです。1つひとつは小さなミスでも、気づかないまま溜まっていくと後から直すのが大変になります。
そこで今回は、このサイト(Zola製)で実際に回している仕組みをベースに、リンク切れや画像の肥大化をデプロイ前に見つけて止めるためのチェック環境をまとめました。
検証環境
- 静的サイトジェネレーター: Zola v0.23.4
- ローカル環境: Windows 11 Pro (PowerShell 7) / Node.js v24.13.0
- CI環境: GitHub Actions
デプロイ前に回しているチェックの全体像
記事を書いてから公開するまでの流れは、ざっくり次のような順番でチェックを通しています。
graph TD
    A["記事Markdownと画像を編集"] --> B["1. Zola標準チェック (内部リンク・構文)"]
    B --> C["2. 外部リンク死活監視 (HTTPステータス)"]
    C --> D["3. 画像最適化とサイズ上限チェック"]
    D --> E{"全チェック通過?"}
    E -->|"失敗"| F["原因箇所を修正して再実行"]
    F --> B
    E -->|"通過"| G["Pull Request / 本番デプロイ"]
普段の執筆中にローカルでサッと叩ける軽さと、GitHub Actionsのプルリクエスト上で最後の抜け漏れを止める仕組みを分けて使っています。
1. まずは Zola の zola check で内部リンクを見る
一番最初に動かすのが、Zola本体に入っているチェックコマンドです。テンプレートの構文エラーや、サイト内のリンク切れ、画像パスの間違いなどをまとめて見てくれます。
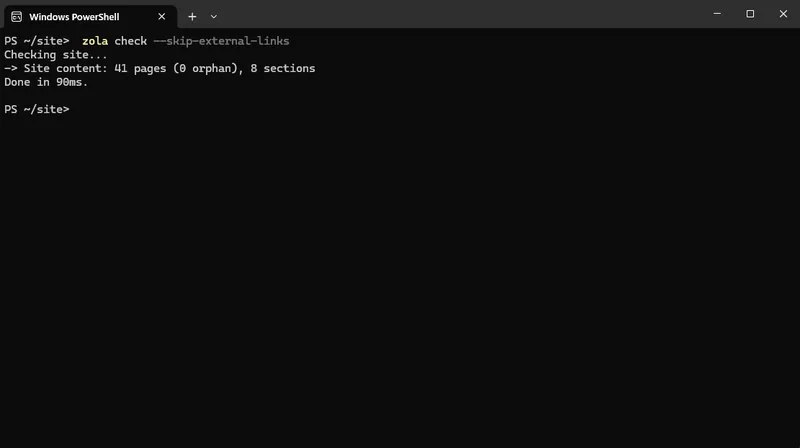
ただ、外部URLへのアクセスまで毎回含めるとネットワーク次第で時間がかかるので、記事を書いている最中は --skip-external-links を付けて内部の整合性だけを確認しています。
zola check --skip-external-links手元で叩いたときの出力はこんな感じです。
Checking site...
-> Site content: 41 pages (0 orphan), 8 sections
Done in 90ms.
41ページあっても約0.1秒で終わるので、記事を保存したあとについ毎回叩く癖がついています。
 編集長
2. 外部リンクの死活監視をスクリプトで回す
zola check だけでも外部リンクのチェックはできますが、記事のコードブロック内に例として書いた https://example.com/... のようなダミーURLまで拾ってエラーになることがありました。
そこで、記事のMarkdownから「実際の本文リンクだけ」を抜き出して並列でチェックするPythonスクリプトを置いています。工夫しているのは、まず ```...``` や `...` の中身を取り除いてから正規表現でURLを拾う点と、ThreadPoolExecutor で並列に投げて待ち時間を減らしている点です。
import re

def extract_links_from_markdown(content):
    # コードブロックとインラインコードを除外して誤検知を防ぐ
    stripped = re.sub(r'```[\s\S]*?```', '', content)
    stripped = re.sub(r'`[^`\n]+`', '', stripped)
    return re.findall(r'\[([^\]]+)\]\((https?:\/\/[^\s\)]+)\)', stripped)
執筆中に回してみたら HTTP 429 が出てハマった話
正直それまで気づいていなかったのですが、この記事を書くついでに手元でスクリプトを全39記事・139リンクに対して回してみたところ、いきなり HTTP 429 が出て止まってしまいました。
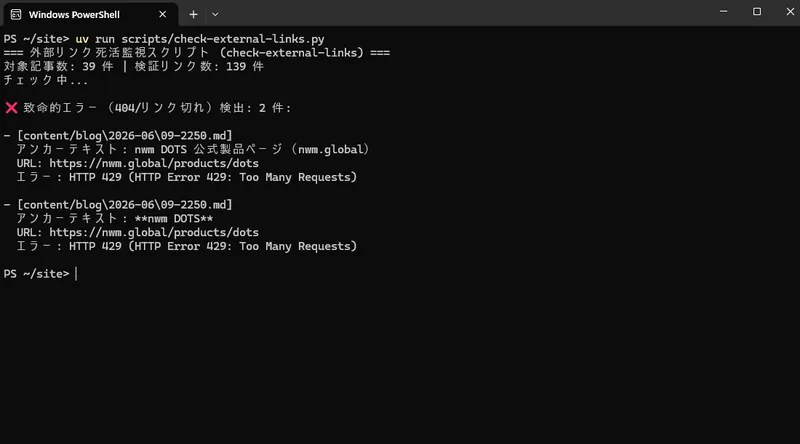
最初は User-Agent がブラウザじゃないから弾かれたのかと思ったのですが、同じ User-Agent のまま単発で1回だけ叩いてみると、普通に HTTP 200 が返ってきます。おかしいなと思って 429 が返ったときのレスポンスヘッダーをそのまま出してみると、原因が見えてきました。
ERR: 429
--- HEADERS ---
retry-after: 60
Server: cloudflare
cf-cache-status: DYNAMIC
調べて分かったのは2つのことです。まず、1つの記事の中に同じ nwm.global のURLが複数回出てきたため、10スレッド並列で一気にリクエストが飛んでレート制限に引っかかっていました。さらに、先方のサイト(Cloudflare + Shopify構成)は User-Agent 文字列だけでなく、TLSフィンガープリントやHTTP/2の挙動、Cookieの保持といった情報から機械的なアクセスを識別して、より厳しいレート制限を掛けているようでした。しかも一度踏むと retry-after: 60 が返ってくるので、2〜3秒待ってリトライした程度では連続で 429 になってしまいます。
スクリプト側を改修して理由が分かるようにした
この動きが分かったので、チェック用のスクリプト自体を見直すことにしました。具体的には、チェック前に同じURLをまとめて重複を減らし、同じドメインへのアクセスはレスポンスが終わってから2〜3秒ほど間隔を空けるようにしています。
あわせて、HTTP 429 を受け取ったときは Retry-After ヘッダーを確認して、60秒のような長い待機を求められたら無駄に再送せず、リンク切れ(404)ではなく警告として流すようにしました。
# 1. URLをユニーク化して同一ホストへの不要なアクセスを削減
url_map = defaultdict(list)
for file_path, text, url in all_entries:
    url_map[url.split('#')[0]].append((file_path, text, url))

# 2. HTTP 429時は Retry-After を確認し、長い待機要求は警告として切り分ける
except urllib.error.HTTPError as e:
    if e.code == 429:
        retry_after = e.headers.get("Retry-After")
        if attempt == 0 and retry_after and retry_after.isdigit() and int(retry_after) <= 5:
            time.sleep(int(retry_after))
            continue
        detail = f"Rate limited (HTTP 429, Retry-After: {retry_after}s)" if retry_after else "Rate limited (HTTP 429)"
        return (clean_url, e.code, detail, False)
    return (clean_url, e.code, str(e), True)
修正したあとに再実行してみた結果がこちらです。
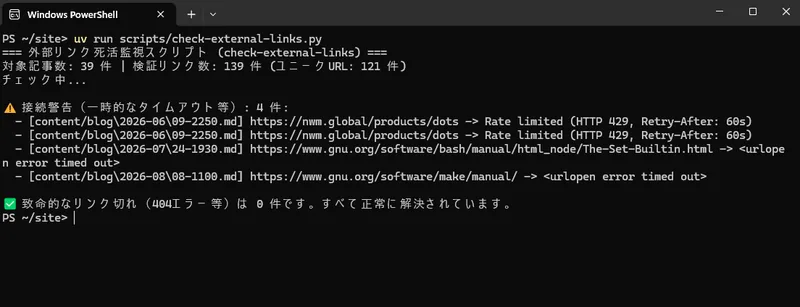
最初のスクリーンショットと見比べると、表示内容が変わっているのが分かります。修正後の出力では 検証リンク数: 139 件 の横に (ユニークURL: 121 件) と出るようになり、重複していた18件分のアクセスを減らせました。また、以前は ❌ 致命的エラー としてビルドを止めていた HTTP 429 が、Retry-After: 60s の理由付きで ⚠️ 接続警告 へ移り、たまたま応答が遅れていた www.gnu.org のタイムアウトとあわせて警告扱いになったことで、致命的なリンク切れは0件として正常終了しています。
ちなみに、「Playwright のような実ブラウザや TLS フィンガープリントを模倣するライブラリを使えば 429 を回避できるのでは」と考えることもできますが、今回はあえて使っていません。ビルド前に毎回回すツールに重いブラウザを持ち込みたくないのと、429 と Retry-After が返ってくる時点でそのサイトが存在していることは分かるため、無理に再アクセスせず警告として引き下がる方が素直で安全だからです。
3. 画像をうっかり重いまま上げない工夫
リンク切れと同じくらい気をつけているのが、画像のファイルサイズです。スクリーンショットや生成画像をそのまま記事に貼ると、1枚で数百KBから1MB近くになってしまい、スマホで開いたときの表示が重くなります。
そこで画像を置くときは必ず最適化スクリプトを通し、アイキャッチなら横幅800px・WebP品質82(だいたい50〜80KB前後)まで落としています。実際にこの記事のスクリーンショット2枚を scripts/optimize-thumbnail.ps1 で変換したときのログはこうなりました。
PS ~/site> pwsh -File "scripts/optimize-thumbnail.ps1" -SourcePath "ss/external-links.png" -DestinationPath "static/img/blog/2026-11/18-1700/external-links.webp"
Optimized thumbnail (WebP): static/img/blog/2026-11/18-1700/external-links.webp
Resolution: 1100x611 -> width <= 800
Size: 50.6 KB -> 19.0 KB (62.5% saved)

PS ~/site> pwsh -File "scripts/optimize-thumbnail.ps1" -SourcePath "ss/zola-check.png" -DestinationPath "static/img/blog/2026-11/18-1700/zola-check.webp"
Optimized thumbnail (WebP): static/img/blog/2026-11/18-1700/zola-check.webp
Resolution: 1111x622 -> width <= 800
Size: 21.0 KB -> 5.6 KB (73.2% saved)
それぞれ 50.6 KB → 19.0 KB(62.5%削減)、21.0 KB → 5.6 KB(73.2%削減)とかなり軽くなりました。あわせて「200KBを超える画像が含まれていたら警告を出す」ようなチェックを挟んでおけば、うっかり無圧縮のPNGをそのままコミットしてしまうミスも防げます。
また、ページ全体の表示崩れやダークモード時の見え方をまとめて確認したいときは、以前書いたPlaywrightでレスポンシブとダークモードを一括撮影する仕組みと組み合わせておくと、見た目と容量の両方をチェックできて安心です。
4. GitHub Actions に乗せて忘れないようにする
ローカルで便利なチェックを作っても、急いでいるときに叩き忘れてそのままプッシュしてしまっては意味がありません。最後の保険として、GitHub Actions でプルリクエストを出したときに自動で回るワークフローを置いています。
name: Site Quality Check

on:
  pull_request:
    branches: [main]

jobs:
  quality-gate:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - name: Install Zola
        uses: taiki-e/install-action@v2
        with:
          tool: zola@0.23.4

      - name: Check internal links and templates
        run: zola check --skip-external-links

      - name: Check external links
run: python3 scripts/check-external-links.pyリリースのたびに変更履歴やタグを自動で更新している環境なら、こうしたチェックを通ったPRだけをマージする流れにしておくと、公開サイトの品質を保ちやすくなります。変更履歴の自動化については、こちらの記事も参考にしてみてください。
まとめ
記事が増えてきた静的サイトを長く運用していくなら、「気をつけて確認する」のではなく、ミスが本番に出る前に自動で止まってくれる仕組みを先に作っておくのが楽です。
zola check --skip-external-linksで内部リンクとテンプレートを毎回サッと確認する- 本文リンクだけを抜き出すスクリプトで、外部URLの404を見つける(429やタイムアウトは警告に逃がす)
- 画像のWebP最適化とファイルサイズ上限をルール化する
- GitHub Actions でプルリクエスト時の最終チェックを固定する
まずは一番手戻りが起きやすい「内部リンクチェック」と「画像最適化」の2つから手元の環境に組み込んでみてください。

都内IT企業に勤める業界20年のWebエンジニア。業務効率化・自動化スクリプトや快適な開発環境の構築、厳選したツール・ガジェットの活用法など、手元で実際に検証したリアルな一次情報をお届けします。